Из чего состоит промпт, который сработает
Одна и та же нейросеть по одному и тому же файлу выдаёт либо пересказ оглавления, либо готовую таблицу с условиями договора. Разница не в модели, а в трёх элементах запроса.
- Роль или контекст. «Ты внимательный юрист», «я заказчик по этому договору». Меняет оптику: один и тот же пункт для заказчика и исполнителя выглядит по-разному.
- Конкретное действие. Не «проанализируй», а извлеки, сравни, посчитай, найди противоречия. Расплывчатый глагол даёт расплывчатый ответ.
- Формат ответа. Таблица с названными колонками, список из 5 пунктов, только CSV без пояснений. Без этого приходит стена текста, которую вы будете разбирать руками.
Как это выглядит на практике. Запрос «проанализируй договор» вернёт пересказ преамбулы и список разделов — то, что и так видно из оглавления. Запрос «ты внимательный юрист, собери таблицу: стороны, срок, стоимость, штрафы, условия расторжения; чего в договоре нет — напиши „не указано“» вернёт готовый документ для принятия решения.
Все 24 промпта ниже собраны по этому принципу. Берите нужный, подставляйте свои данные в квадратных скобках и отправляйте вместе с прикреплённым файлом.
Промпты для документов и договоров
1. Пересказ для того, у кого нет времени
Проблема. Прислали документ на 40 страниц, решение нужно принять сегодня, а читать целиком некогда.
Решение. Заставить модель отсеять всё, что не влияет на решения, и оставить только то, что меняет картину.
Почему работает. Ограничение в 7 пунктов вынуждает модель ранжировать информацию, а не пересказывать подряд. Прямой запрет на пустые формулировки убирает канцелярит, которым обычно заполняется половина резюме.
2. Ключевые условия договора в таблицу
Проблема. Нужно быстро понять условия, не выискивая их по разделам, где они намеренно разнесены.
Решение. Задать роль юриста и жёсткий список полей, которые нужно заполнить.
Почему работает. Названные колонки не оставляют пространства для импровизации. Инструкция про «не указано» важнее, чем кажется: без неё модель заполнит пустую ячейку стандартной формулировкой из типового договора, и вы решите, что условие есть.
3. Что здесь невыгодно лично мне
Проблема. Договор формально нормальный, но перекос в чью-то сторону виден только опытному глазу.
Решение. Указать свою сторону сделки — тогда анализ перестаёт быть нейтральным и становится полезным.
Почему работает. Указание стороны меняет всю оптику: один и тот же пункт про односторонний отказ выгоден одной стороне и опасен для другой. Требование цитаты даёт возможность проверить вывод за секунды.
4. Сравнение двух версий
Проблема. Контрагент прислал «версию с небольшими правками», и надо понять, что изменилось на самом деле.
Решение. Отделить смысловые изменения от косметических и показать их построчно.
Почему работает. Колонки «было» и «стало» заставляют документировать каждое изменение, а не констатировать факт различий. Отдельная строка про удалённые разделы закрывает самый частый способ спрятать правку — просто убрать неудобный пункт.
5. Поручения из протокола встречи
Проблема. После совещания остался протокол на несколько страниц, а нужны только задачи и ответственные.
Решение. Дать модели роль секретаря и попросить именно поручения, отсеяв обсуждение.
Почему работает. Колонка со статусом — ключевая деталь. Без неё модель смешивает принятые решения и то, что просто прозвучало в обсуждении, и половина «задач» окажется чьими-то идеями вслух.
6. Вопросы, которые стоит задать
Проблема. Документ прочитан, но непонятно, где в нём слабые места, о которых надо спросить другую сторону.
Решение. Попросить не анализ, а список вопросов — это другой режим мышления и другой результат.
Почему работает. Запрос на вопросы вместо выводов переключает модель с пересказа на поиск пробелов. Умолчания в документах опаснее прямых формулировок, а именно их обычный анализ пропускает — их же в тексте нет.
Промпты для сканов и PDF
7. Оцифровка бумажного документа
Проблема. Есть скан или фотография документа, а нужен текст, с которым можно работать.
Решение. Попросить перенос с сохранением структуры и честной отметкой нераспознанных мест.
Почему работает. Разрешение написать «неразборчиво» снимает с модели давление выдать гладкий результат. Без этой фразы она заполнит пробел логичным по смыслу словом, и вы никогда не узнаете, что там было на самом деле.
8. Проверка цифр после распознавания
Проблема. В распознанном документе есть суммы и реквизиты, а ошибка в одной цифре меняет всё.
Решение. Вынести все числа в отдельный список с контекстом и пометкой рискованных мест.
Почему работает. Проверять 15 чисел в списке в разы быстрее, чем вычитывать документ. Просьба отметить рискованные места использует то, что модель видит качество исходника и может показать, где именно стоит присмотреться.
9. Разбор счёта или квитанции
Проблема. Пришёл счёт с десятками позиций, и надо понять, за что именно платите и сходится ли итог.
Решение. Попросить не только таблицу позиций, но и сверку итога с тем, что указано в документе.
Почему работает. Сверка своего расчёта с документом — это встроенная проверка. Если распознавание сбилось на одной позиции, расхождение итогов сразу это покажет.
10. Конспект по фотографиям страниц
Проблема. Есть снятые на телефон страницы методички, а нужен рабочий конспект.
Решение. Запросить не пересказ, а структуру понятий плюс проверочные вопросы.
Почему работает. Вынесение формул в отдельный блок спасает их от растворения в тексте. Вопросы для самопроверки заставляют модель выделить то, что в материале действительно ключевое, — побочный, но полезный эффект.
Промпты для таблиц и данных
11. Что вообще в этих данных
Проблема. Прислали выгрузку, а с чего начать — непонятно.
Решение. Разделить запрос на два шага: сначала описание структуры, потом наблюдения.
Почему работает. Описание структуры перед анализом работает как проверка: если модель перечислила не те колонки, файл прочитан неверно, и дальше можно не читать. Требование неочевидности отсекает наблюдения уровня «больше всего строк в категории А».
12. Сводка по числовой колонке
Проблема. Нужны базовые показатели, а открывать табличный редактор ради пяти чисел не хочется.
Решение. Запросить конкретный набор метрик и заодно узнать, что с пропусками.
Почему работает. Медиана рядом со средним сразу показывает перекос в данных. Вопрос про пропуски критичен: молча выброшенные строки — самая частая причина, по которой сумма из ответа не сходится с реальностью.
13. Поиск аномалий
Проблема. В выгрузке наверняка есть мусор, но искать его глазами по тысяче строк невозможно.
Решение. Перечислить конкретные типы проблем, а не просить «найти ошибки».
Почему работает. Перечень типов работает как чек-лист — модель проходит по нему, вместо того чтобы выбирать, что считать ошибкой. Колонка с критичностью позволяет не тонуть в мелочах.
14. Разбивка по категориям
Проблема. Нужен срез «сколько чего по каждой группе», а сводная таблица — это отдельная возня.
Решение. Задать группировку, метрику и сортировку одной фразой.
Почему работает. Доля в процентах превращает список чисел в картину: сразу видно, дают ли три верхние категории 80% результата или всё размазано ровно.
15. Перевод текста в структуру
Проблема. Данные лежат в тексте сплошняком, а нужны в виде таблицы для дальнейшей работы.
Решение. Задать точные колонки и попросить чистый результат без комментариев.
Почему работает. Фраза «только CSV, без пояснений» переключает модель из разговорного режима в режим выдачи данных — результат можно копировать сразу, не вычищая вводные предложения.
Промпты для кода и конфигов
16. Объясни, что делает этот файл
Проблема. Достался чужой проект, и надо быстро понять роль конкретного файла.
Решение. Задать уровень собеседника и структуру объяснения.
Почему работает. Уточнение уровня убирает объяснение базовых конструкций языка. Вопрос «откуда данные и куда уходят» даёт понимание места файла в системе, а не только того, что в нём написано.
17. Поиск ошибки по коду и скриншоту
Проблема. Есть ошибка на экране и файл кода, но связь между ними неочевидна.
Решение. Приложить оба файла сразу и попросить версии по убыванию вероятности.
Почему работает. Возможность приложить пять файлов в одном сообщении позволяет дать модели и код, и картинку ошибки — это принципиально больше контекста, чем пересказ ошибки словами. Просьба показать только изменённый фрагмент экономит время на чтении.
18. Ревью с приоритетами
Проблема. Обычное ревью даёт свалку замечаний, где критичное лежит вперемешку с вкусовщиной.
Решение. Заранее задать три корзины и отсортировать внутри них.
Почему работает. Категория «вкусовщина» — главная находка этого промпта. Она даёт модели легальное место, куда сложить стилистические придирки, и они перестают засорять важное.
19. Разбор конфигурации
Проблема. В конфиге сотня параметров, и неясно, какие из них реально что-то меняют.
Решение. Попросить объяснение блоков плюс отдельно опасное и оставленное по умолчанию.
Почему работает. Забытые значения по умолчанию — источник большинства проблем с конфигами, и заметить их при обычном чтении сложно именно потому, что они выглядят нормально.
20. Оптимизация запроса к базе
Проблема. Запрос работает, но медленно, а где именно теряется время — непонятно.
Решение. Сначала разбор логики по шагам, потом предложения.
Почему работает. Требование сначала описать порядок выполнения — это форма рассуждения вслух. Модель разбирает запрос по частям и находит проблемные места, которые пропустила бы, отвечая сразу.
Промпты для картинок и скриншотов
21. Данные с графика в таблицу
Проблема. В отчёте есть график, а исходных чисел к нему нет.
Решение. Попросить снять значения и честно пометить те, что оценены на глаз.
Почему работает. Разделение на точные и приблизительные значения не даёт превратить прикидку по шкале в якобы точные данные, на которые потом кто-то сошлётся.
22. Разбор схемы или диаграммы
Проблема. Схема процесса выглядит понятной, но слабые места на ней не видны.
Решение. Сначала описать схему текстом, потом искать проблемы.
Почему работает. Перевод картинки в текст перед анализом — это способ убедиться, что модель поняла схему правильно. Если в описании перепутаны стрелки, все дальнейшие выводы можно не читать.
23. Проверка интерфейса по скриншоту
Проблема. Свой продукт замылен, и понять, что видит новый пользователь, невозможно.
Решение. Задать взгляд человека, который зашёл впервые, и потребовать конкретных правок.
Почему работает. Вопрос про совпадение главного действия с бизнес-задачей ловит частую ошибку интерфейсов, когда визуально выделена не та кнопка, которая нужна.
24. Перенос текста с фотографии
Проблема. После встречи осталась исписанная доска или страница заметок.
Решение. Попросить сохранить не только текст, но и связи, нарисованные стрелками.
Почему работает. Стрелки на доске несут половину смысла. Без прямого указания модель перенесёт только надписи, и логика, ради которой всё рисовалось, потеряется.
Команды-модификаторы для уточнения
Короткие фразы, которые можно добавить к любому промпту из списка выше. Работают как настройки поведения.
| Команда | Что делает | Когда нужна |
|---|---|---|
| Отвечай только на основе прикреплённого файла | Запрещает достраивать ответ из общих знаний | Договоры, внутренние документы, любые данные, где выдумка недопустима |
| Для каждого пункта укажи, откуда он взят | Заставляет привязывать вывод к месту в документе | Когда результат придётся защищать или перепроверять |
| Действуй по шагам и покажи ход рассуждения | Разбивает задачу на этапы, снижает число ошибок | Расчёты, многоступенчатый анализ, разбор логики |
| Игнорируй раздел [название] | Убирает из анализа шум, который сбивает фокус | Документы с длинными приложениями или историей компании |
| Если данных нет — напиши, что их нет | Разрешает модели признать отсутствие информации | Всегда, когда заполняете таблицу по документу |
| В конце задай мне один уточняющий вопрос | Превращает ответ в диалог и подсвечивает, чего не хватило | Первый заход по незнакомому документу |
Слабый промпт против сильного: 6 примеров
Принцип из начала статьи на шести типовых задачах. Средняя колонка — то, что вы получите, если поленитесь дописать вторую половину запроса.
| Задача | Слабый промпт | Что получится | Сильный промпт |
|---|---|---|---|
| Разобрать договор | Проанализируй договор | Пересказ преамбулы и список разделов — то, что и так видно из оглавления | Ты внимательный юрист. Собери таблицу: стороны, срок, стоимость, штрафы, условия расторжения, автопродление. Чего в договоре нет — напиши «не указано» |
| Найти данные в отчёте | Найди важные цифры | Случайная выборка чисел вперемешку с номерами страниц | Выпиши все суммы и проценты. Для каждого укажи, что он означает и в каком разделе встречается. Номера страниц и даты в общем формате игнорируй |
| Сравнить две версии | Сравни эти файлы | «Документы похожи, есть небольшие отличия в формулировках» | Найди смысловые различия, форматирование игнорируй. Таблица: пункт, было, стало, почему это важно. Удалённые разделы — отдельной строкой |
| Прочитать скан | Что тут написано | Сплошной текст без структуры, ошибки распознавания незаметны | Перенеси текст, сохранив нумерацию пунктов и таблицы. Неуверенно распознанные места отметь как [неразборчиво], не подставляй правдоподобный вариант |
| Разобрать таблицу | Проанализируй данные | Описание того, какие есть колонки, без единого вывода | По колонке «Выручка» посчитай сумму, среднее, медиану, минимум и максимум. Покажи 5 крайних строк целиком. Скажи, сколько пропусков и как ты с ними поступил |
| Проверить код | Что тут не так | Общие советы про читаемость, которые подходят любому коду | Раздели замечания на три группы: критично, стоит поправить, вкусовщина. По каждому — номер строки и объяснение в одном предложении |
Закономерность одна и та же во всех шести строках: сильный запрос добавляет роль, конкретное действие и формат ответа. Если свой промпт не работает, проверьте, какого из трёх элементов в нём не хватает.
7 ошибок, из-за которых ответ получается бесполезным
Если промпт скопирован, а результат всё равно не тот, причина почти всегда в одной из семи вещей ниже. Первые две встречаются чаще остальных и заметить их сложнее всего.
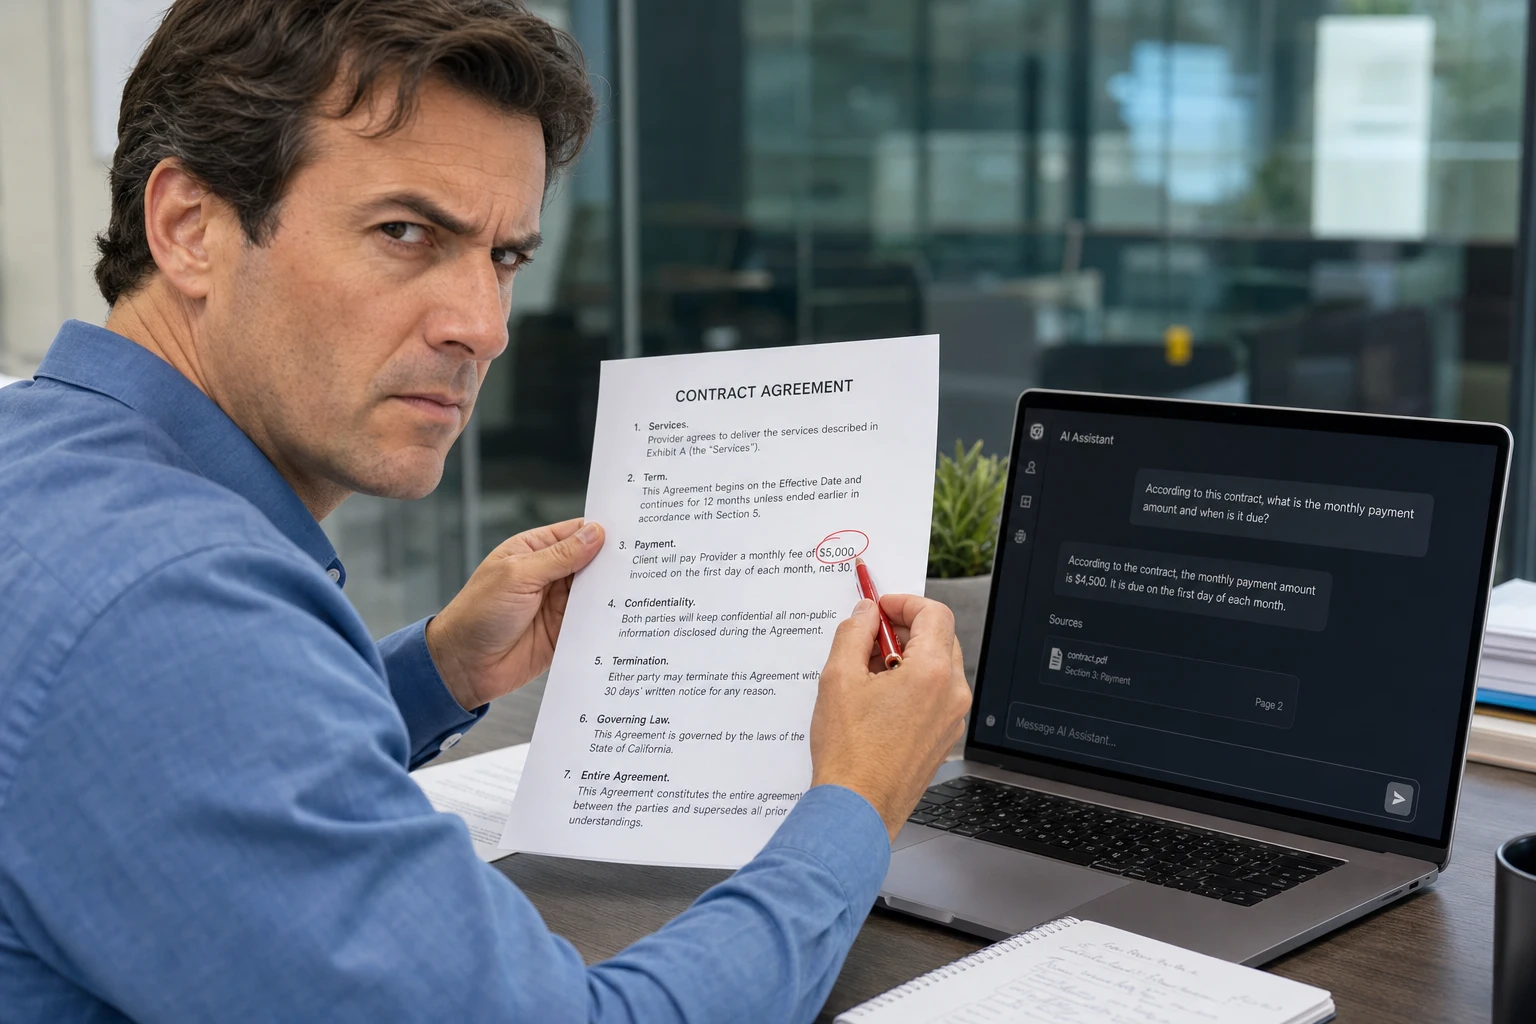
1. Файл загружен без задачи
Запрос «посмотри файл» не содержит ничего, за что модель может зацепиться. Она обязана что-то ответить и выдаёт самое безопасное — общее резюме. Задача должна быть в первом же сообщении: не «посмотри договор», а «найди в договоре все условия расторжения».
2. Никто не проверил, что файл дочитан до конца
Это самая коварная ошибка, потому что признаков нет. Длинный текстовый файл обрезается на 100 000 знаках молча — модель не сообщит, что видела только половину, и уверенно ответит по той части, которая до неё дошла. Вы получите правдоподобный ответ по первым 50 страницам договора и не узнаете об этом.
3. Расплывчатые глаголы
«Проанализируй», «найди важное», «оцени» — слова без содержания. Для вас важное в отчёте о продажах это провалившиеся регионы, для модели — то, что чаще упоминается в тексте. Заменяйте глагол на конкретное действие: извлеки, сравни, посчитай, перечисли, найди противоречия.
4. Формат ответа не задан
Без указания формата приходит стена текста, которую потом разбираешь вручную — то есть работа не сделана, а перенесена. Одна фраза «ответ дай таблицей с колонками: пункт, было, стало» экономит больше времени, чем всё остальное в промпте.
5. Цифрам после распознавания скана верят на слово
Скан проходит через распознавание текста, и на плохом исходнике цифры путаются: 6 превращается в 8, точка теряется. Сумма в ответе будет выглядеть абсолютно уверенно. Если в документе есть деньги и даты, отдельно просите выписать их списком с указанием места — сверить десять чисел быстрее, чем перечитывать документ.
6. Одна огромная инструкция вместо цепочки
Промпт с семью требованиями сразу приводит к тому, что модель делает всё понемногу и ничего толком. Три коротких запроса подряд в одном диалоге дают заметно более глубокий результат: контекст сохраняется, а внимание каждый раз сфокусировано на одной задаче.
7. Модели не запретили додумывать
Если в документе нет ответа на ваш вопрос, модель по умолчанию попробует его достроить из общих знаний — и выдаст правдоподобную выдумку. Фраза «отвечай только на основе прикреплённого файла, если данных нет — так и напиши» убирает большую часть таких случаев.
6 приёмов для сложных задач
1. Проверьте, что файл дошёл
Перед сложной задачей спросите: «Сколько разделов в документе и как называется последний?» Ответ покажет, прочитан ли файл целиком.
2. Начните с плана документа
Если файл большой, сначала попросите оглавление с ключевыми темами. Потом разбирайте разделы по очереди — точность вырастет заметно.
3. Не начинайте новый чат
Если ответ не устроил, уточняйте в той же ветке: «сфокусируйся на разделе 4, остальное пропусти». Второй заход почти всегда точнее.
4. Покажите пример результата
Одна строка нужного формата работает лучше, чем три предложения его описания. Модель копирует структуру примера.
5. Сохраняйте удачные промпты
Запрос, который сработал идеально, через неделю не вспомнится. Пять минут на личный файл с находками экономят часы.
6. Прогоните файл через две модели
Один документ, два разных ответа — расхождения сразу показывают места, где стоит проверить оригинал.
Последний приём стоит пояснить, потому что он самый недооценённый. Модели ошибаются по-разному: одна теряет детали в середине длинного документа, другая слишком уверенно достраивает недостающее. Когда один и тот же договор разобран двумя моделями и они разошлись в пункте про неустойку — это точный указатель, куда смотреть в оригинале. В Нейрочате переключение между моделями происходит в том же окне, так что файл не нужно загружать заново. Если хочется собирать запросы аккуратнее с нуля, пригодится разбор структуры промпта.
Что нейросеть принимает: форматы и лимиты
Техническая часть. Пригодится, если файл не загружается или ответ по нему получается неточным.
| Тип | Форматы | Что происходит с файлом |
|---|---|---|
| Картинки | JPEG, PNG, WebP, GIF | Модель видит изображение целиком: читает текст на скриншоте, разбирает схему, описывает фото |
| Проходит через распознавание текста, поэтому читаются и обычные документы, и сканы, и фотографии страниц | ||
| Word | .docx | Текст вместе с содержимым таблиц извлекается и подставляется в запрос |
| Текст и данные | .txt, .md, .csv, .log, .json | Содержимое вставляется в запрос как обычный текст |
| Веб | .html, .css, .js, .jsx, .ts, .tsx | То же самое: код читается как текст |
| Языки программирования | .py, .java, .c, .cpp, .go, .rb, .php | Читается как текст, модель видит структуру и комментарии |
| Конфиги и запросы | .xml, .yml, .yaml, .sql, .sh | Читается как текст, удобно для разбора настроек и запросов к базе |
Лимиты: 20 МБ на файл, до 5 вложений в одном сообщении, до 100 000 знаков из одного текстового файла. Договор на 100 страниц весит около 1 МБ, так что упереться в размер реально только с тяжёлыми сканами и картинками высокого разрешения. А вот лимит по знакам — это примерно 50 страниц плотного текста, и его достичь легко.
Почему один и тот же файл в разных форматах даёт разный результат
Файлы попадают в модель тремя разными способами, и от этого зависит качество ответа.
- Картинка уходит как изображение — модель видит расположение элементов и цвета, а не только текст. Поэтому только на картинке можно спросить, почему диаграмма выглядит странно.
- PDF обрабатывается движком распознавания mistral-ocr. Это не извлечение текстового слоя, а полноценное распознавание, поэтому сканы и фотографии страниц читаются наравне с обычным PDF.
- Текст и код просто вставляются в запрос как текст. Отсюда два следствия: такие файлы работают с любой моделью, и промежуточной обработки, на которой можно что-то потерять, у них нет.
Что не поддерживается и чем заменить
| Не поддерживается | Что делать |
|---|---|
| Excel — .xlsx, .xls | Сохранить лист как CSV: «Файл — Сохранить как — CSV». Формулы превратятся в значения, что для анализа обычно даже удобнее |
| Старый Word — .doc | Открыть в Word или бесплатном редакторе и пересохранить как .docx |
| Аудио и видео | Сделать текстовую расшифровку любым сервисом транскрибации и загрузить как .txt |
| Архивы — .zip, .rar | Распаковать и загрузить нужные файлы по отдельности, до 5 штук за раз |
| Презентации — .pptx | Экспортировать в PDF — он читается полностью, включая текст на слайдах |
И ещё две вещи, которых не стоит ждать ни от какой модели. Нейросеть не редактирует загруженный файл и не возвращает исправленную версию — она отдаёт текст ответа, который вы сами вставляете куда нужно. И она не считает как калькулятор: сложение сотни строк делается рассуждением, а не арифметикой, поэтому итоговые суммы стоит перепроверять.
Где работать с файлами
| Сервис | Что читает | Сканы | Доступ из России | Выбор моделей |
|---|---|---|---|---|
| Нейрочат | PDF, DOCX, картинки, 23 расширения текста и кода | Да, распознавание текста | Без VPN, оплата картой российского банка | ChatGPT, Claude, DeepSeek, Gemini, Grok в одном окне |
| ChatGPT напрямую | PDF, DOCX, XLSX, картинки | Да | Нужен VPN и зарубежная карта | Только модели OpenAI |
| Claude напрямую | PDF, DOCX, картинки, код | Да | Нужен VPN и зарубежная карта | Только Claude |
| Gemini напрямую | PDF, DOCX, картинки, видео | Да | Нужен VPN и зарубежная карта | Только Gemini |
Сравнение честное в обе стороны: у сервисов напрямую есть то, чего пока нет у нас. ChatGPT читает Excel без пересохранения, Gemini принимает видео. Если эти форматы — основа вашей работы и вопрос с оплатой и VPN уже решён, разумно пользоваться ими.
Загрузите документ и спросите главное
В Нейрочате собраны все лучшие нейросети — ChatGPT, Claude, DeepSeek, Gemini — без VPN и сложных настроек.
▶ Попробовать бесплатноЧасто задаваемые вопросы
Чаще всего причина в запросе, а не в модели. Слова «проанализируй» и «найди важное» не несут информации: модель не знает, что важно именно вам, и выдаёт общее резюме. Рабочий запрос всегда содержит три вещи — роль или контекст, конкретную задачу и формат ответа. Замена «проанализируй договор» на «собери таблицу: стороны, сроки, суммы, штрафы» меняет результат сильнее, чем смена модели.
Задайте контрольный вопрос до основной задачи: «Сколько разделов в документе и как называется последний?» Если ответ не совпадает с оригиналом, файл прочитан не полностью. Это важно, потому что длинные текстовые файлы обрезаются на 100 000 знаках молча, без предупреждения.
В Нейрочате текстовый чат принимает PDF, DOCX, картинки (JPEG, PNG, WebP, GIF) и 23 расширения текста и кода — от .txt, .csv и .json до .py, .sql и .yaml. Лимит — 20 МБ на файл и до 5 вложений в одном сообщении. Excel, старый .doc, аудио, видео и архивы пока не поддерживаются, но у каждого есть простой обходной путь.
Да. PDF в Нейрочате обрабатывается движком распознавания текста mistral-ocr, поэтому скан договора или фотография страницы читаются так же, как обычный текстовый PDF. Качество зависит от исходника: ровный контрастный скан распознаётся почти без ошибок, мятая бумага под углом — заметно хуже, поэтому суммы и даты стоит перепроверять по оригиналу.
Нейрочат — самый удобный вариант для пользователя из России: русский интерфейс, оплата картой российского банка, работа без VPN и все топовые модели (ChatGPT, Claude, DeepSeek, Gemini, Grok) в одном окне, так что один и тот же файл можно прогнать через несколько моделей и сравнить ответы, не загружая его заново. ChatGPT, Claude и Gemini напрямую тоже читают документы, но требуют зарубежную карту и VPN.